Este guia explica como estruturar um cenário de automação com foco em eficiência, segurança e manutenção. De forma objetiva, revisa o que significa automação industrial, quais componentes costumam compor uma solução e por que a integração entre sensores, controladores e sistemas de supervisão reduz falhas. Também aborda boas práticas de implementação, testes e requisitos comuns.
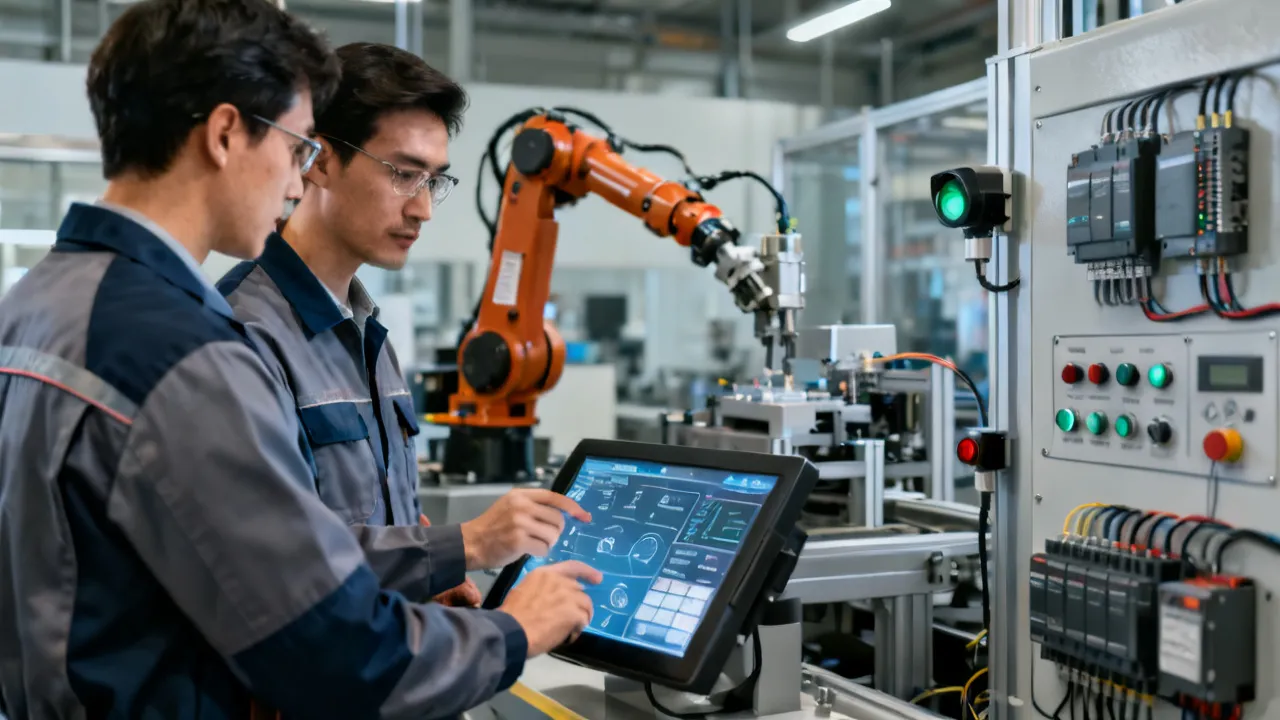
Um cenário de automação bem desenhado começa pelo alinhamento entre processo produtivo, requisitos de segurança e estratégia de integração de dados. Em vez de tratar a automação como “um conjunto de máquinas”, o olhar profissional prioriza a cadeia: sensoriamento (aquisição), controle (decisão em tempo real) e supervisão (visibilidade e registro). Assim, a operação tende a reduzir paradas não planejadas e melhorar a rastreabilidade — sem depender de “atalhos” técnicos.
Ao longo dos anos, um padrão se repete nas plantas industriais: projetos que dão certo não são os que “instalam mais tecnologia”, e sim os que definem com clareza o que o sistema deve fazer em cada situação do processo. Isso envolve decisões sobre estado do processo, comportamento em falha, critérios de aceitação, política de alarmes e até mesmo sobre como a manutenção e a operação irão interagir com o software. Em outras palavras: o cenário de automação é, essencialmente, o mapa operacional e de engenharia que permite que o sistema seja previsível.
Quando se fala em automação, normalmente está se referindo à substituição de ações manuais por controles automáticos baseados em regras, medições e eventos. Em ambientes industriais, isso costuma envolver:
Na prática, o valor aparece quando o cenário de automação é desenhado para suportar o ciclo completo: comissionamento, operação, manutenção, diagnóstico e evolução. Essa visão é consistente com diretrizes técnicas publicadas por organizações de referência em automação e segurança funcional, como a IEC e boas práticas industrialmente aceitas.
Mas vale um alerta: muitas definições de automação ficam “bonitas” na teoria e ficam incompletas na execução. Por isso, ao montar o cenário, você precisa decidir qual automação será implementada: automação com foco em controle de processo (garantir parâmetros dentro de limites), automação com foco em sequenciamento (coordenar etapas), automação com foco em qualidade (rastrear lotes, garantir inspeções), automação com foco em segurança (parada segura e redução de risco) e automação com foco em disponibilidade (reduzir tempo de parada, automatizar diagnósticos e recovery).
Em geral, o cenário de automação precisa responder a perguntas do tipo: “Se o sensor A falhar, o processo deve parar imediatamente? Deve degradar e continuar? Deve exigir intervenção do operador?” Sem essas decisões, a automação vira um conjunto de decisões implícitas — e decisões implícitas geralmente quebram no primeiro incidente real.
Em muitos projetos, o termo cenário automação é usado para destacar que não basta escolher equipamentos; é preciso definir como o processo se comporta e como a informação circula. Um cenário coerente normalmente inclui:
Esse tipo de estrutura reduz retrabalho, porque decisões de arquitetura (por exemplo, como tratar estados “parcial”, “degradado” e “seguro”) costumam ser feitas cedo.
Quando falamos em “fluxo de dados”, é comum alguém pensar apenas em comunicação entre CLP e SCADA. Mas, para um cenário completo, o fluxo de dados inclui:
Decidir “cenário” é decidir o que será considerado correto para cada variável do processo e onde cada informação deve aparecer. Por exemplo: um alarme deve ser exibido com a mesma etiqueta e descrição no SCADA e na planilha de manutenção? O histórico deve registrar o valor medido no momento do evento ou apenas a condição (ex.: “temperatura fora de faixa”)? Essas escolhas influenciam diretamente o esforço de investigação quando ocorre um incidente.
Automação sem critérios claros de segurança tende a criar um cenário frágil. Por isso, projetos profissionais tratam segurança como requisito de engenharia, não como etapa final. Em termos práticos:
Referências formais como a IEC 61508 (base de segurança funcional) e a IEC 62061/ISO 13849-1 (famílias para avaliação de segurança) são amplamente reconhecidas na indústria. O objetivo não é “decorar normas”, mas usar critérios verificáveis para reduzir riscos.
Um ponto que muitas equipes subestimam é a diferença entre segurança funcional e “rotinas de controle” convencionais. Há sistemas que “param” o processo quando algo dá errado, mas isso não necessariamente significa que atendem requisitos de segurança funcional. Para decidir corretamente, você precisa definir:
Confiabilidade também é uma decisão: o cenário deve deixar claro como o sistema responde a falhas comuns de campo, como vibração que afeta sensores, ruído elétrico que causa leituras erráticas, cabo mal crimpado, perda intermitente de rede, atuador travado ou sobrecorrente. A confiabilidade não é um “plus”; é resultado de engenharia aplicada a falhas reais.
Além disso, existe um componente organizacional: se a equipe de manutenção não tem procedimentos para recuperar o sistema após uma parada de segurança, a planta pode ficar improdutiva, mesmo com automação funcionando. Por isso, o cenário precisa conectar tecnologia e rotina operacional: o sistema deve informar de forma acionável o que ocorreu e o que deve ser verificado.
Do ponto de vista de um especialista, a arquitetura ideal é aquela que facilita operação e manutenção. Um desenho típico em cenário de automação pode seguir a lógica:
Em projetos que miram evolução, é comum padronizar nomenclaturas, classes de tags e estratégias de alarmes para que a operação não “perca” o sistema ao longo do tempo.
Para tornar essa arquitetura realmente útil, você precisa tomar decisões adicionais que costumam estar implícitas em diagramas:
Também é importante decidir sobre separação de responsabilidades: por exemplo, se a decisão de sequência principal fica no CLP (mais comum), o supervisório deve apenas oferecer telas e comandos (handshake bem definido). Já em alguns projetos mais avançados, parte da lógica de supervisão pode coordenar produção, mas ainda precisa estar coerente com a lógica de controle para evitar “duelo de decisões”.
Você pode encontrar ofertas com variações relevantes conforme escopo, marcas, integrações e nível de engenharia. Ainda assim, como regra profissional, a melhor maneira de discutir preço é separar custo por categorias:
Essa decomposição evita comparações injustas entre propostas que “parecem iguais”, mas diferem na parte que realmente reduz paradas e retrabalho.
Para enriquecer a tomada de decisão, vale também discutir custo total de propriedade (TCO) e custo de ciclo de vida. Uma automação mais cara pode ser mais barata no longo prazo se reduzir:
Outro elemento costuma gerar “surpresa”: licenças e infraestrutura. Às vezes, o preço base parece competitivo, mas depois aparecem custos relacionados a:
Portanto, ao decidir “o que” incluir no cenário, você também decide “o que” vai sustentar o custo. A pergunta não é apenas “quanto custa”, mas “quanto custa manter e evoluir, com confiabilidade e segurança”.
Mesmo quando o projeto está bem definido, a execução depende do fornecedor e de sua capacidade de acompanhar requisitos. Para avaliar fornecedor de um cenário de automação, um checklist útil inclui:
Na prática, um bom fornecedor reduz risco ao tornar previsível o que será entregue — e como será verificado.
Mas há decisões que precisam ser cobradas com clareza. Por exemplo:
Além disso, em cenários que envolvem segurança funcional, a competência do fornecedor se torna crítica. Não basta “ter componentes de segurança”; é necessário aplicar o processo de engenharia de segurança e manter evidências. Uma proposta sem documentação e sem estratégia de validação tende a ser um risco, especialmente em auditorias futuras.
Um cenário automação raramente “dá certo” só por instalar equipamentos. A implementação deve seguir uma sequência técnica. Abaixo está uma abordagem orientada a resultados, com ênfase em validação.
Em termos de engenharia, existe um ciclo que se repete em projetos bem-sucedidos: (1) entender o processo, (2) definir requisitos e limites, (3) projetar lógica e arquitetura, (4) integrar hardware e software, (5) testar em condições reais e de falha, (6) comissionar com evidência, (7) entregar para operação e (8) criar governança para mudanças e melhorias.
Entretanto, na prática do dia a dia, o que define o sucesso é a forma como essas etapas se traduzem em decisões. Você pode seguir a sequência e ainda assim falhar se, por exemplo,:
Por isso, o cenário deve ser tratado como um “produto de engenharia” com requisitos, testes e vida útil, e não como uma atividade pontual de instalação.
| Fase / módulo | Objetivo técnico | Critérios de pronto (condições) | Boas práticas |
|---|---|---|---|
| Levantamento e requisitos | Definir o comportamento do processo e limites operacionais. | Escopo formalizado, lista de entradas/saídas, estados do processo e metas de disponibilidade. | Mapear intertravamentos, modos de falha e prioridades de alarmes desde o início. |
| Arquitetura e redes | Planejar comunicação, endereçamento e robustez do sistema. | Definição de protocolo, topologia, endereçamento e plano de redundância quando necessário. | Padronizar nomenclatura e documentação de tags para reduzir erro humano. |
| Projeto de controle | Construir lógica modular, estados e validações de leitura. | Controle replicável por módulos, testes unitários e rastreabilidade de lógica por requisito. | Usar máquinas de estados e lógicas com verificação de consistência de sinais. |
| Integração de supervisão | Garantir visibilidade, alarmes e histórico coerentes. | Alarmes classificados, telas por tarefa e criticidade; registro confiável de eventos. | Evitar excesso de alarmes: priorizar causa, impacto e resposta esperada. |
| Segurança funcional | Implementar e validar rotinas de parada segura e intertravamentos. | Testes de aceitação com evidências; conformidade com critérios aplicáveis do domínio. | Tratar segurança como requisito de engenharia com verificação documentada. |
| Comissionamento e testes | Validar desempenho em condições reais. | FAT/SAT quando aplicável, plano de testes, resultados registrados e checklist de prontidão. | Testar cenários de falha (sensor/atuador/loop), não apenas operação nominal. |
| Treinamento e handover | Capacitar operação e manutenção para responder a incidentes. | Manuais, procedimentos e simulações de resposta a alarmes críticas. | Criar rotas de troubleshooting e responsabilidades claras por turno. |
| Operação e melhoria contínua | Ajustar parâmetros e reduzir eventos recorrentes. | Plano de mudanças, governança de versões e registro de aprendizados. | Usar métricas de eventos e tempo de reparo para direcionar melhorias. |
Para deixar a tabela ainda mais útil, vale também estabelecer uma “ponte” entre as fases: por exemplo, o que nasce no levantamento (requisitos) precisa ser rastreado para testes (comissionamento). Isso significa ter uma matriz de rastreabilidade que conecte requisito → implementação → teste → evidência. Sem isso, a validação vira opinião, e opinião não é comprovação.
Além disso, é recomendável definir desde cedo quais variáveis serão tratadas como “operacionais” (exibidas e usadas na rotina) e quais serão “técnicas” (usadas para diagnóstico). Essa separação ajuda a evitar que operadores sejam sobrecarregados com informações demais, e ajuda a manter a supervisão mais clara e eficiente.
Em projetos de automação industrial, é comum ancorar decisões em padrões e diretrizes técnicas reconhecidas. Como referência geral, normas da família IEC 61508 (segurança funcional), ISO 13849-1 (segurança de máquinas) e IEC 61784 (redes industriais e sistemas relacionados, conforme aplicação) costumam orientar requisitos e validações. Para integração e qualidade de dados de chão de fábrica, também se utiliza frequentemente documentação de boas práticas de redes industriais e manutenção baseada em ciclo de vida.
Ao decidir um cenário de automação, o profissional precisa compreender o que é aplicável e o que é opcional. Por exemplo, nem todo projeto exige o mesmo nível de rigor de segurança funcional. Ainda assim, quase sempre existe um mínimo de requisitos de segurança (paradas de emergência, intertravamentos, modos de operação e procedimentos). A escolha deve ser baseada em análise de risco e no contexto do processo.
O mesmo vale para redes industriais: diferentes níveis de criticidade e disponibilidade pedem diferentes arquiteturas de comunicação. Um sistema que apenas exibe dados pode tolerar atrasos maiores; um sistema que coordena movimento ou segurança funcional precisa de previsibilidade e robustez. Decidir a arquitetura de redes é decidir como a informação chega ao controle e como o sistema se comporta em condições reais, como degradação de sinal, perda de pacote e recuperação após queda.
Para ampliar ainda mais esse passo a passo, é útil acrescentar decisões “silenciosas” que frequentemente determinam o resultado:
Essas decisões reduzem risco e evitam que o sistema “aceite” ações indevidas durante intervenções, uma causa comum de acidentes e de danos a equipamentos.
Um modo prático de garantir essas condições é criar “requisitos observáveis”. Em vez de escrever “o sistema deve ser robusto”, você escreve requisitos como: “Quando a comunicação PLC-SCADA cair por mais de X segundos, o supervisório deve manter o último estado confiável e exibir um alarme de comunicação com categoria Y”. Esse tipo de requisito é testável e reduz ambiguidades.
Também é importante decidir como será tratado o ciclo de vida do dado. Em integrações, por exemplo:
Essa governança de dados geralmente é determinante para rastreabilidade e auditorias.
Ao avaliar projetos de automação em diferentes setores, o padrão é claro: a maioria das dificuldades aparece quando o cenário não prevê “casos fora do nominal”. Algumas práticas reduzem esse risco:
Erros comuns que merecem atenção adicional (e que frequentemente aparecem após o go-live):
Evitar esses erros não depende apenas de “boa vontade”. Depende de engenharia com validação: simular falhas, revisar estados e garantir que a supervisão traduz a lógica sem ruído.
Embora o tema seja técnico, a forma de apresentar o cenário de automação à equipe influencia o resultado. Em ambientes industriais no Brasil, por exemplo, costuma ser útil que o supervisório use termos alinhados à rotina do time (ex.: como operadores descrevem “parada programada” e “parada por falha”), evitando jargões que não estejam na operação. Em visitas de campo, é comum ver que a aceitação melhora quando telas e relatórios refletem a forma como a equipe descreve o processo no dia a dia.
Para tornar essa adaptação efetiva, você pode decidir:
O cenário de automação precisa “conversar” com as rotinas. A tecnologia existe para reduzir esforço humano e risco operacional, não para aumentar a carga cognitiva do operador.
Um cenário de automação “maduro” é aquele que suporta o pós-go-live. Isso significa:
Para sustentar o pós-go-live, o cenário deve incluir uma estratégia de melhoria contínua. Isso pode ser estruturado com:
Outra parte do ciclo de vida que vale decidir é como lidar com “aging” do sistema: sensores envelhecem, cabos degradam, atuadores perdem desempenho, e o controle pode precisar de ajuste. Se o cenário não foi desenhado para acomodar esse ciclo, a manutenção vira improviso. Já quando existe diagnóstico e parâmetros bem governados, a planta aprende com os dados e melhora progressivamente.
É a descrição integrada de como o processo opera e como sensores, controladores e supervisão se coordenam. Inclui estados do processo, intertravamentos, política de falhas e fluxo de dados, para que o sistema seja verificável e mantenível.
Além da descrição, um cenário de automação precisa ser testável e auditável: deve existir forma de verificar que o sistema cumpre aquilo que foi especificado e que as evidências podem ser apresentadas para manutenção, operação e (quando aplicável) auditoria de segurança.
Automação é o conceito amplo (integração de medição, decisão e execução). Um projeto de controle é uma parte central, focada na lógica de execução e temporização no controlador. Um bom cenário automação integra controle, supervisão e requisitos operacionais.
Em outras palavras, um projeto de controle pode funcionar “em bancada”, mas sem um cenário completo, o operador pode não compreender os estados, os alarmes podem ser incoerentes, a rastreabilidade pode falhar e o sistema pode ser difícil de recuperar após falhas.
Considere experiência semelhante, metodologia de entrega, clareza de critérios de aceite, capacidade de documentação e suporte em operação. O fornecedor ideal não apenas “entrega hardware”, mas viabiliza testes, comissionamento e uma transição segura para a rotina.
Um critério prático: peça que o fornecedor apresente como realiza testes de falha e como registra evidências. Se a resposta for genérica (“testamos tudo no comissionamento”), isso pode indicar ausência de rigor. Se a resposta trouxer plano, casos, critérios e rastreabilidade, aumenta a confiança.
Normalmente não. O custo deve ser avaliado considerando escopo, engenharia, testes, documentação, integração e treinamento. Uma proposta mais barata pode ficar mais cara se aumentar retrabalho, elevando risco de paradas e dificuldades de manutenção.
Vale relembrar: automação barata tende a ser cara quando o sistema falha, porque a manutenção não tem diagnóstico e a operação não tem clareza. A diferença de custo inicial se dilui quando você estima MTTR, paradas evitadas e redução de incidentes.
Você deve exigir um plano de testes com evidências (o que será testado, como será medido e critérios de aceitação), além de validações de alarmes, estados e comportamentos em falhas. Sem isso, o cenário fica “opaco” para manutenção e operação.
Também é aconselhável exigir que os testes incluam situações não usuais, como falha de sensor, falha de atuador, variação de sinal fora de faixa, atraso de comunicação e retorno após reinicialização. Isso costuma diferenciar um comissionamento “de checklist” de um comissionamento que realmente valida o sistema.
De forma sistemática: defina estados degradados, intertravamentos e procedimentos. Simule falhas durante testes para confirmar que o controlador e o supervisório reagem corretamente e fornecem mensagens acionáveis.
Uma abordagem comum é classificar falhas em: (a) falha detectável imediatamente com ação segura, (b) falha com detecção por tempo de execução (timeout), (c) falha intermitente e (d) falha silenciosa (quando o sinal aparenta plausibilidade, mas o comportamento não bate com o processo). O cenário deve abordar cada categoria de forma clara.
A supervisão torna o sistema operável: exibe estados reais, gera alarmes com criticidade, registra histórico e fornece interfaces para manutenção e análise. Em cenário de automação, supervisão e controle precisam refletir a mesma lógica e definições de estado.
Sem supervisão bem desenhada, o controle pode estar correto tecnicamente, mas a operação não consegue operar com segurança e eficiência. Por isso, a política de alarmes, os textos e a navegação nas telas são parte do cenário.
É a troca estruturada de informações entre o ambiente de controle e sistemas externos (quando aplicável). Isso pode envolver registro de eventos, parâmetros e rastreabilidade. Para evitar inconsistência, é importante definir campos, timing e validação.
Integração também inclui decisões sobre sincronização: como evitar divergência entre “o que o controle acredita” e “o que o sistema externo registrou”. Por exemplo, se houver atraso no envio de dados, qual será a forma de reconciliar? Isso precisa estar previsto no cenário para garantir confiança nos relatórios.
Ao estruturar um cenário automação com foco em requisitos, segurança, arquitetura de integração e testes baseados em evidências, você transforma a automação em um ativo de confiabilidade — não em um conjunto de equipamentos difíceis de operar. Se a sua meta é estabilidade e manutenção previsível, o ponto central é simples: desenhar o sistema para funcionar no nominal e no fora do nominal, com documentação e critérios de aceite desde o início.
Quando esse princípio é seguido, a automação deixa de ser um projeto “técnico” apenas para se tornar um sistema que sustenta o negócio: reduz perdas, melhora rastreabilidade, acelera recuperação de falhas e cria base para evolução futura. E, principalmente, cria previsibilidade — algo essencial para quem precisa operar, manter e melhorar uma planta com segurança e eficiência.



This guide explains how to evaluate SKU 750816 procurement and supplier fit for consistent quality and predictable lead times. Objectively, the keywords relate to identifying a specific item, comparing supplier capabilities, and validating sourcing conditions using documented specifications, commercial terms, and traceable documentation. The focus is practical decision-making grounded in standard supply-chain due diligence.
This guide explains how to approach Fygf with a disciplined sourcing method, focusing on pricing logic and supplier due diligence. Objectively, Fygf is treated here as a procurement-related keyword representing a specific product or service category. Background coverage clarifies how market pricing, lead times, documentation, and quality controls connect—so decisions can be made with confidence.
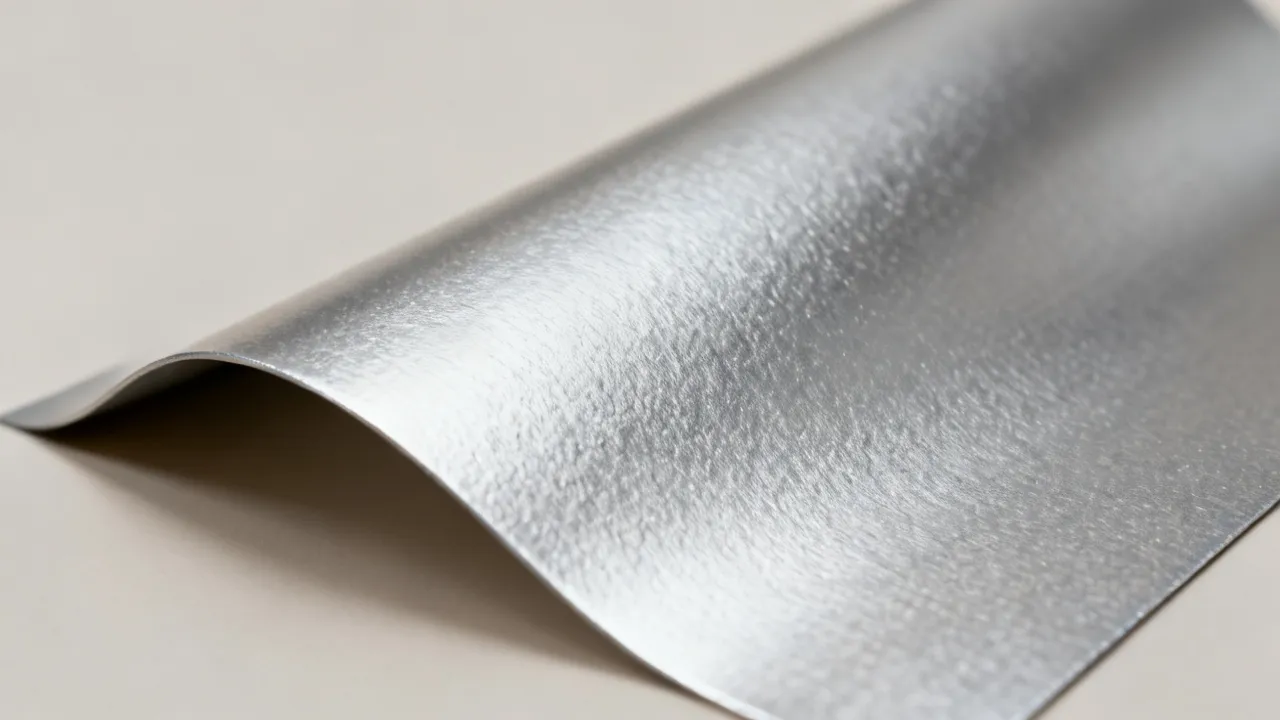
Fulepelata es un material metálico con aplicaciones decorativas e industriales donde importan el acabado, el espesor y la trazabilidad. Este documento explica, de forma objetiva, qué significa el término, por qué se valora en talleres y proyectos, y cómo comparar calidades al solicitar cotizaciones, junto con requisitos habituales de compra, criterios de recepción y preguntas frecuentes para una decisión informada.
Este guia explica, de forma objetiva, como funciona a gestão e organização de informações ligadas ao GSN Contagem, destacando boas práticas, critérios de escolha e cuidados essenciais. Em seguida, contextualiza o termo no ambiente corporativo, discutindo por que empresas utilizam padronização e controles para reduzir riscos operacionais e melhorar a governança.
This guide explains how to evaluate Uu-related pricing and supplier options with a disciplined, risk-aware approach. Objectively, “Uu” functions as a label used across procurement and product catalogs to reference a specific item set or internal code. The article outlines sourcing criteria, supplier validation, and decision conditions for consistent outcomes.
This guide explains how “9i” and related terms—especially “ ”—can be evaluated for smart sourcing decisions, with an objective lens on what to verify before choosing a supplier. It outlines background context, selection criteria, and practical workflows so teams can compare options consistently, manage requirements, and reduce procurement risk while maintaining quality standards.

