A Automação Dicionario organiza conhecimento e padroniza termos para que sistemas atuem com consistência. O guia explica, de forma objetiva, o que é um dicionário de automação, como ele reduz ambiguidades entre equipes e ferramentas, e por que decisões de mapeamento e governança impactam qualidade, manutenção e rastreabilidade em processos operacionais.
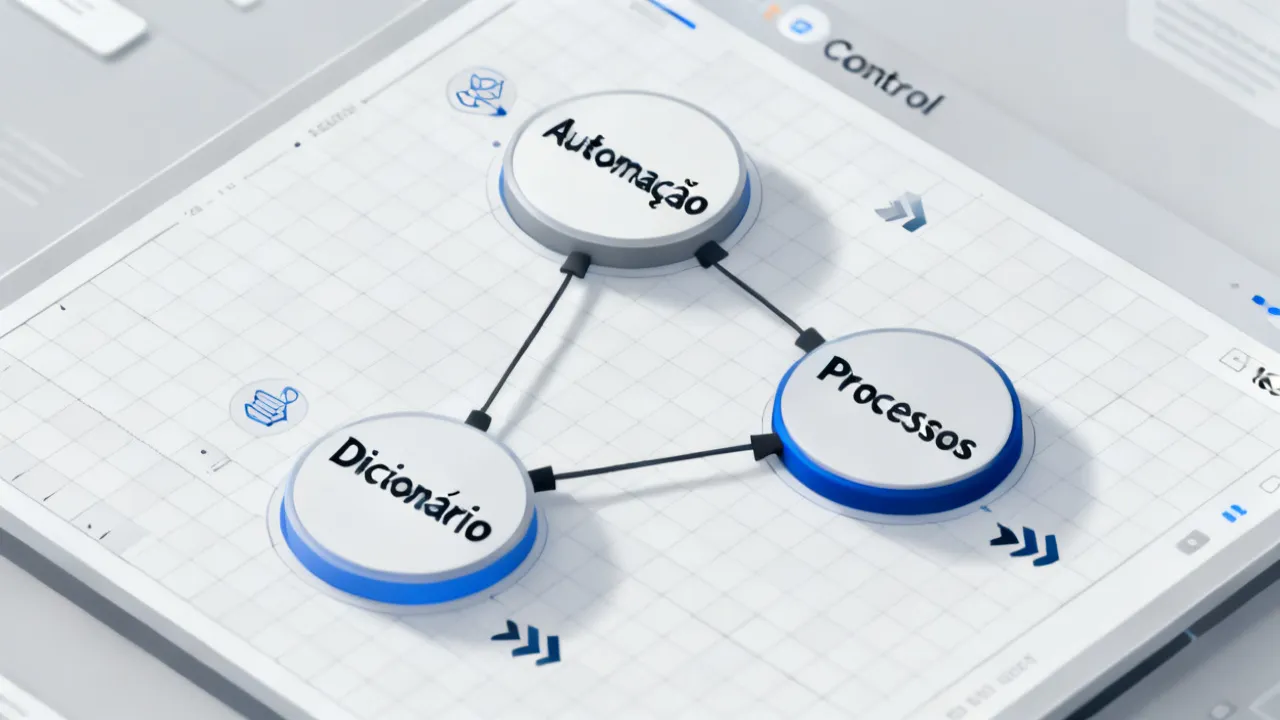
Quando se fala em Automação Dicionario, o ponto central é simples: um dicionário de termos, regras e mapeamentos transforma dados soltos em linguagem operacional. Na prática, isso reduz variações, melhora a previsibilidade e dá base para automações que “entendem” o mesmo significado em diferentes etapas—da captura à execução. Em outras palavras, o dicionário funciona como uma ponte semântica: ele garante que “o que foi dito” em um sistema seja o mesmo “que foi entendido” em outro, e que, quando chegar a hora de decidir e agir, a automação use critérios estáveis e auditáveis.
Como especialista em processos e governança de automação, eu trato Automação Dicionario como um ativo: ele não é só um repositório, mas um mecanismo de padronização e validação contínua. Ao desenhar esse mecanismo, você cria uma forma de governar significado — algo que muitas iniciativas de automação ignoram. A consequência natural dessa negligência costuma aparecer nos sintomas clássicos: decisões erradas por interpretação divergente, aumento de exceções, retrabalho, dificuldade para explicar mudanças e manutenção cara porque “ninguém sabe de onde veio a regra”.
A seguir, você verá como estruturar esse conceito de modo técnico, com atenção a requisitos, condições e trade-offs típicos do setor. Além do “como fazer”, eu incluo o “como não fazer”: os pontos onde as equipes costumam confundir dicionário com documentação, ou onde transformam o dicionário em um espaço que cresce sem controle (o chamado “cemitério de exceções”). O objetivo é manter a coerência entre semântica, execução e governança.
Em muitas organizações, a automação falha não por falta de tecnologia, mas por inconsistência semântica: cada equipe usa nomes diferentes para a mesma entidade (cliente, produto, serviço, status), cada sistema registra campos de forma própria e cada regra interpreta eventos com critérios diferentes. O Automação Dicionario aparece para resolver esse descompasso por meio de definições padronizadas.
De forma objetiva, um dicionário de automação costuma incluir:
Assim, o dicionário funciona como camada de interpretação entre o que sistemas capturam e o que automações executam. Quando isso é bem feito, você passa a ter previsibilidade: decisões deixam de ser “opiniões implementadas em código” e passam a ser “resultado de um modelo semântico governado”.
É comum que iniciativas de automação sejam avaliadas sob a lente de infraestrutura: qual orquestrador, qual linguagem, qual plataforma de integrações, qual ferramenta de workflow. Porém, a maior causa de instabilidade quase sempre está em como os dados são interpretados.
Exemplos típicos de falha semântica:
O Automação Dicionario atua justamente nessa lacuna: ele explicita o significado e define como interpretar variações. Isso reduz a distância entre “dados brutos” e “decisão confiável”.
Automação não é apenas “rodar tarefas”. É garantir que resultados sejam consistentes ao longo do tempo, independentemente de quem altere formulários, integrações ou regras. Um Automação Dicionario bem construído ajuda a:
Em relatórios de qualidade e governança, essa abordagem costuma ser citada de maneira indireta por disciplinas como gestão de dados e controle de mudanças. Para embasamento conceitual, vale observar recomendações gerais de governança e qualidade de dados presentes em materiais do Gartner (governança de dados) e do DAMA (disciplina de gestão de dados, quando aplicável). Como referência pública e frequentemente citada em gestão, o DAMA-DMBOK estrutura boas práticas para governança e qualidade, ainda que não trate de “Automação Dicionario” com esse nome. O paralelo conceitual é claro: consistência semântica, definição de papéis (ownership), gestão de mudanças e qualidade operacional.
Quando implementei e reviso arquiteturas similares, noto um padrão: dicionários bem-sucedidos começam pequenos, mas com governança desde o início. O erro recorrente é tentar mapear “tudo” de uma vez, sem critérios de prioridade. Outro erro frequente é tratar o dicionário como um “artefato estático” — em vez disso, ele precisa ser operável, isto é, consultado na execução e atualizado com base em evidências.
Um bom desenho geralmente segue esta lógica:
Essa estrutura reduz fragilidade e evita que o dicionário vire um “documento morto”. A diferença essencial é: o dicionário precisa ser parte do mecanismo que toma decisões, e não apenas algo que descreve decisões passadas.
Um dicionário semântico pode crescer rapidamente. Para manter coerência, você precisa definir escopo: quais entidades fazem parte do dicionário, quais atributos se comportam como “domínios”, e quais regras são globais versus locais.
Uma forma útil de pensar é separar:
Ao separar, você reduz o risco de “inchar” o dicionário com exceções locais. Exceções locais podem existir, mas precisam ser classificadas e justificadas, e idealmente não contaminar o significado global.
Você mencionou price information e supplier details, mas não foram fornecidos valores, fornecedores, moedas ou condições específicas. Para manter este guia objetivo e sem inventar números, segue uma forma profissional de avaliar o custo de implantação de um Automação Dicionario sem depender de preços não verificados.
Se você fornecer faixa de preço, moeda, região e possíveis fornecedores, eu posso transformar esta seção em uma estimativa comparativa (por exemplo, por pacotes ou por atividades), sempre evitando números sem lastro. Mas, independentemente do valor, a abordagem correta é orçar por etapas e por capacidade (tempo e esforço) — porque a complexidade semântica costuma variar mais do que a complexidade “técnica” da implementação.
Mesmo sem detalhes de supplier details informados, há critérios técnicos que normalmente diferenciam fornecedores e equipes internas na construção de Automação Dicionario:
Como guia de referência de mercado, relatórios de analistas como Gartner discutem, de maneira geral, tendências de governança, qualidade e automação inteligente. Como não foram fornecidos preços, não é apropriado afirmar “quanto custa” sem base. O foco aqui é orientar escolhas estruturais, alinhadas ao que realmente evita falhas: semântica, validação, integração e governança.
Para que o dicionário gere valor, ele precisa “encostar” no fluxo real de automação. Na prática, isso acontece em três pontos: na entrada (antes da regra), na decisão (durante a execução) e na saída (para consumo por outros sistemas). Essa integração em três momentos é o que transforma um dicionário de “referência” em componente de controle.
Quando dados chegam (formulários, eventos, mensagens, tickets, registros de ERP/CRM), o dicionário normaliza: identifica o termo canônico, interpreta códigos e aplica regras de validação. Isso impede que fluxos tomem decisões com base em texto livre inconsistente.
Na prática, a entrada passa por um pipeline de normalização e interpretação. Esse pipeline pode incluir:
Importante: a decisão de quando rejeitar versus quando aceitar como “desconhecido” deve ser governada por regra, não por “sensibilidade” do desenvolvedor. Isso evita inconsistência de tratamento em diferentes fluxos.
As condições do fluxo (if/else, roteamento, aprovações) passam a referenciar termos do dicionário. Em vez de “se o status contiver ‘andamento’”, você faz “se status for ‘EM_ANDAMENTO’”. Isso reduz fragilidade e melhora manutenção.
Há duas abordagens comuns:
A escolha depende de latência, volume e arquitetura. Em geral, para alta escala, o enriquecimento no ingresso tende a ser mais performático; para cenários onde termos mudam com frequência, consulta dinâmica pode ser preferível, desde que haja cache e mecanismos de versionamento.
O dicionário também orienta como registrar resultados: qual status enviar, qual campo preencher e como codificar eventos para que downstream systems interpretem corretamente. Isso evita que a automação “entenda bem” mas “comunique mal”.
Exemplo de problema típico: uma automação decide que um ticket está “pronto para aprovação” mas envia o texto “Aprovacao” para outro sistema que espera “READY_FOR_APPROVAL”. Sem dicionário na saída, a correção ocorre no downstream, aumentando o tempo de ciclo e a chance de erro.
Com Automação Dicionario, a saída deve ser padronizada com base em regras do dicionário: sempre que um evento for publicado, os campos semânticos devem seguir a forma canônica vigente.
| Aspecto | Com “Automação Dicionario” | Sem padronização semântica |
|---|---|---|
| Significado dos termos | Canônico e documentado (com sinonímia e normalização) | Varia por equipe, documento e origem |
| Regras de decisão | Consultam o dicionário (menor ambiguidade) | Baseadas em texto livre e heurísticas |
| Manutenção | Atualizações via versionamento do dicionário | Mudanças espalhadas em múltiplos fluxos |
| Auditoria | Rastreia versão de regras/termos em uso | Difícil explicar por que decidiu de certo modo |
| Onboarding | Documentação padronizada e operável | Curva de aprendizado maior e dependente de “quem sabe” |
| Tratamento de exceções | Classificado e governado (ex.: DESCONHECIDO com rota definida) | Exceções ad hoc sem critérios consistentes |
A seguir, um roteiro prático e objetivo para estruturar o Automação Dicionario com foco em consistência, governança e execução confiável. Eu vou além do “passo a passo” tradicional e incluo também como validar e como operar com ciclo de melhoria contínua.
Liste as entidades relevantes para automação: status, categorias, tipos de solicitação, motivos de reprovação, prioridade, canal, SLA e outros campos que influenciam regras. Identifique onde hoje há variação ou exceções.
Nessa etapa, é útil coletar exemplos reais: amostras de eventos e registros por origem. A qualidade do dicionário depende da qualidade das amostras. Um dicionário construído apenas com “definições de reunião” tende a falhar em dados sujos, abreviações e erros tipográficos.
Ao mapear, procure responder:
Para cada entidade, escolha um formato canônico (nome e/ou código). Em seguida, descreva sinônimos, variações de texto e normalizações esperadas.
Dica de governança: canônico precisa ter ownership semântico. Se dois times “acham” que o significado é deles, a ambiguidade vira disputa. Defina um responsável (owner) e um comitê ou mecanismo de aprovação.
Para cada origem (ex.: API, planilha, ticket, formulário), defina como transformar a entrada em termo canônico. Inclua validações de:
Um ponto crítico: mapeamento e validação devem ser testáveis. Se as regras forem tão complexas que ninguém consegue prever o comportamento, você perde a vantagem do dicionário. Complexidade deve ser gerenciada e documentada.
Sem governança, o dicionário vira um amontoado de exceções. Crie um processo simples de aprovação: quem propõe, quem valida, em que prazo e como o impacto é avaliado.
Uma governança madura geralmente define:
Além disso, defina se mudanças podem ser “retroativas”. Em geral, mudanças sem retroatividade evitam inconsistência: registros antigos podem permanecer com a versão canônica antiga, enquanto novos registros usam a versão nova. Porém, para certos casos legais/auditáveis, pode ser necessário reprocessamento.
Antes de colocar em produção, rode testes com amostras representativas e casos-limite. O objetivo é verificar se o dicionário:
Boas práticas de teste para Automação Dicionario incluem:
Um teste bem desenhado reduz risco de “melhorar agora e quebrar depois”. A semântica é sensível, e por isso precisa ser tratada como parte do contrato do sistema.
Mesmo com bom desenho inicial, o contexto muda. Ajuste o dicionário com base em falhas recorrentes, amostras de “não mapeado” e feedback operacional. Se possível, use indicadores de qualidade como taxa de mapeamento bem-sucedido e taxa de exceções.
Algumas métricas úteis:
O ciclo de melhoria deve fechar loop com as fontes: se a origem tem alta taxa de “não mapeado”, talvez a solução seja ajustar o formulário, padronizar dropdowns ou melhorar validações na captura, reduzindo o trabalho do dicionário.
| Requisito | Por que importa | Como verificar |
|---|---|---|
| Escopo definido (entidades e decisões) | Evita migração infinita e reduz complexidade | Lista priorizada e acordada entre áreas |
| Fonte de verdade (owner semântico) | Evita conflitos de interpretação | Quem “aprova” cada termo é claro |
| Versionamento e trilha | Permite auditoria e manutenção sem surpresa | Histórico disponível e regras vinculadas à versão |
| Teste com casos reais | Garante que automação se comporta como esperado | Conjunto de testes com amostras e bordas |
| Processo de mudança | Evita que o dicionário “quebre” fluxos | Fluxo de aprovação e janela de deploy |
| Documentação operável | O time mantém e evolui com autonomia | Guia de uso que alguém não técnico consegue seguir |
| Integração runtime | Garante que dicionário afeta decisão de fato | Logs e evidências de que fluxos consultam o dicionário |
| Estratégia para “não mapeado” | Evita silêncio e decisão errada | Definição de rota: rejeitar, corrigir, sinalizar, reprocessar |
Ao estruturar Automação Dicionario, alguns riscos aparecem com frequência:
Mitigações típicas incluem testes, versionamento, aprovação e um ciclo de melhoria contínua ancorado em dados de operação. O ponto é tratar semântica como contrato do sistema: qualquer mudança tem impacto e precisa ser gerida.
Esse padrão de padronização semântica aparece em diferentes frentes:
Em geral, o retorno aparece quando há volume suficiente e diversidade de entradas. Se a automação é rara e as entradas são sempre padronizadas, o dicionário pode ter menor impacto. Mas, na maioria das organizações, a realidade é heterogênea, e o dicionário passa a ser uma camada de estabilidade.
Além da arquitetura, há disciplina “de conteúdo”. O dicionário precisa ser legível e verificável. Recomendo:
Uma boa prática é tratar o dicionário como “modelo de domínio” (domain model) e não como “lista de rótulos”. A semântica deve ser correta e estável; rótulos podem mudar com a UI, mas os canônicos não devem oscilar sem governança.
Considere que uma automação roteia tickets de atendimento. Sem dicionário, o fluxo pode fazer: “se status contém ‘andamento’ então envia para fila A”. A partir de variações reais, surgem erros quando o status vem como “EM_EXECUCAO”, “em andamento”, “no fluxo” e “executando”.
Com Automação Dicionario, você define:
O resultado é previsível: independentemente de como o upstream escreve o status, a automação trabalha com o mesmo significado canônico. Isso reduz erros e facilita manutenção.
Em aprovações, um mesmo texto pode ser interpretado de formas diferentes dependendo do contexto. Por exemplo, “documentação incompleta” pode significar: falta de anexos, falta de assinatura, ou falta de informação específica. Se o dicionário tratar tudo como um único termo canônico, você perde granularidade para ações posteriores.
Com Automação Dicionario, você pode:
Esse desenho evita decisões erradas. O ponto-chave é que ambiguidade não deve ser “ignorada”; ela deve ser tratada com critérios e estratégia.
É a prática de usar um dicionário de termos, regras e mapeamentos para padronizar a interpretação de dados e orientar decisões em fluxos de automação, reduzindo ambiguidade e melhorando manutenção e auditoria. Na prática, ele cria um “contrato semântico” entre fontes de dados e mecanismos de decisão.
Se o sistema “funciona” mas depende de heurísticas ou regras baseadas em texto livre, é provável que a manutenção futura seja mais cara. O dicionário tende a reduzir retrabalho e erros quando surgem novas variações de entrada, mudanças de nomenclatura ou ajustes em formulários e integrações.
Com governança e critérios claros: definir escopo inicial, versionar, exigir aprovação para novos termos e transformar exceções recorrentes em regras de mapeamento generalizáveis. Além disso, é essencial classificar exceções (ex.: erro de origem, variação textual, mudança de domínio) e medir a taxa de exceções ao longo do tempo.
Em geral, os ganhos se somam. A curto prazo, a qualidade e a redução de erros costumam aparecer primeiro; depois vem a previsibilidade de manutenção e a rastreabilidade para auditoria e explicação de decisões. Em ambientes regulados, auditoria pode virar o principal motor do ganho — porque decisões precisam ser explicáveis.
Ele não elimina regras do fluxo; ele melhora a base semântica. Em vez de regras baseadas em variações de texto, as regras passam a consultar termos canônicos e critérios de validação do dicionário. O fluxo continua responsável por lógica de workflow, mas a interpretação dos dados fica padronizada.
Sim. A recomendação profissional é começar por entidades e decisões de maior impacto, validar com casos reais e evoluir com versionamento e governança. O segredo é escolher um “primeiro conjunto” que gere aprendizado e evidência sem assumir que o escopo total está totalmente conhecido.
Não. O valor aparece quando o dicionário é consultado em execução (padronização na entrada, referência na decisão e padronização na saída). Documentação ajuda, mas não substitui a integração operacional. Uma documentação sem execução tende a criar discrepância: “o fluxo decide diferente do que está escrito”.
Você pode acompanhar indicadores como taxa de mapeamento bem-sucedido, redução de exceções e retrabalho, e estabilidade de resultados após mudanças (medidas de qualidade e consistência). O ideal é definir metas no início do projeto, alinhadas ao impacto esperado (ex.: redução de não mapeados, redução de correções manuais, melhoria no SLA).
Quando uma fonte altera nomenclatura, códigos ou comportamento de campos, o dicionário deve reagir via governança: identificar impacto, criar novo mapeamento ou regra de validação, versionar e controlar o deploy. Em paralelo, é recomendável ajustar a origem sempre que possível, para reduzir a dependência do dicionário em variações futuras.
Se não há owner semântico ou se múltiplas fontes divergem, você precisa estabelecer uma estratégia de resolução: qual fonte prevalece em quais cenários, ou como conciliar divergências (ex.: preferência por data de atualização, ou regra de precedência por sistema). Sem isso, o dicionário pode até padronizar termos, mas não padroniza o “verdadeiro significado” quando as fontes disputam.
O Automação Dicionario é um componente estratégico para transformar automação em algo confiável ao longo do tempo. Ao padronizar significados, criar mapeamentos verificáveis e operar com governança e versionamento, você reduz ambiguidade, acelera a manutenção e melhora rastreabilidade—benefícios que costumam sustentar a evolução do processo mesmo quando as fontes de dados mudam.
Em vez de “consertar” cada variação dentro de cada fluxo, o dicionário cria um ponto único de controle semântico. Isso melhora qualidade operacional e facilita auditorias e explicações. Em última instância, a automação deixa de ser frágil e passa a ser governada por um modelo de significado, reduzindo o risco de regressões e aumentando a capacidade do time de evoluir com segurança.
Se você quiser, compartilhe: (1) quais entidades/status você precisa padronizar, (2) quais sistemas estão envolvidos e (3) se existe um fornecedor ou faixa de price information já levantada. Com isso, eu posso adaptar este guia para seu cenário com um plano de implantação mais específico, incluindo prioridades, critérios de governança e estratégia para validação e versionamento.



Este guia analisa como a Automação Dicionario apoia padronização, mapeamento de termos e integração de fluxos para reduzir retrabalho e melhorar a governança. Em base objetiva, o texto contextualiza automação, dicionários de dados e requisitos de qualidade. Também detalha um passo a passo de implantação, comparações de abordagem e condições de uso, além de FAQs voltadas a times de processos e TI.
A automação apoiada por um “Automação Dicionario” melhora consistência, reduz retrabalho e acelera decisões. O texto contextualiza, de forma objetiva, o que significa usar dicionários como base de regras e mapeamentos. Em seguida, apresenta critérios para selecionar fornecedores, definir etapas e requisitos, além de uma visão prática sobre governança, qualidade de dados e integração a sistemas.
A automação baseada em “Automação Dicionario” melhora a consistência de regras, padroniza conteúdo e reduz retrabalho em rotinas de processamento de texto e dados. O guia explica, de forma objetiva, o que é automação com dicionário, quais cuidados usar na modelagem e como avaliar fornecedores, capacidades e requisitos técnicos para uma implementação sustentável.
Este guia explica como estruturar o “Automação Dicionario” para padronizar regras, melhorar integrações e reduzir inconsistências operacionais. Em termos objetivos, o conceito envolve organizar terminologia, campos e comportamentos em uma base de conhecimento reutilizável. Também descreve como fornecedores e custos variam conforme escopo, maturidade do ambiente e requisitos de governança, incluindo condições para implantação.
A Automação Dicionario organiza conhecimento e padroniza termos para que sistemas atuem com consistência. O guia explica, de forma objetiva, o que é um dicionário de automação, como ele reduz ambiguidades entre equipes e ferramentas, e por que decisões de mapeamento e governança impactam qualidade, manutenção e rastreabilidade em processos operacionais.
A Automação Dicionario organiza definições, regras e mapeamentos para acelerar integrações e reduzir ambiguidades operacionais. O texto contextualiza, de forma objetiva, o que é um dicionário de automação, como ele apoia padronização de dados e decisões, e quais requisitos organizacionais favorecem a adoção em ambientes de TI e negócios.

