Este guia explica como estruturar um Scenario Automação para integrar processos, dados e controles com segurança operacional. Em seguida, apresenta de forma objetiva o que envolve automação industrial, por que a escolha do fornecedor impacta o retorno, e como alinhar requisitos técnicos, governança e etapas de implantação para reduzir riscos e aumentar previsibilidade.
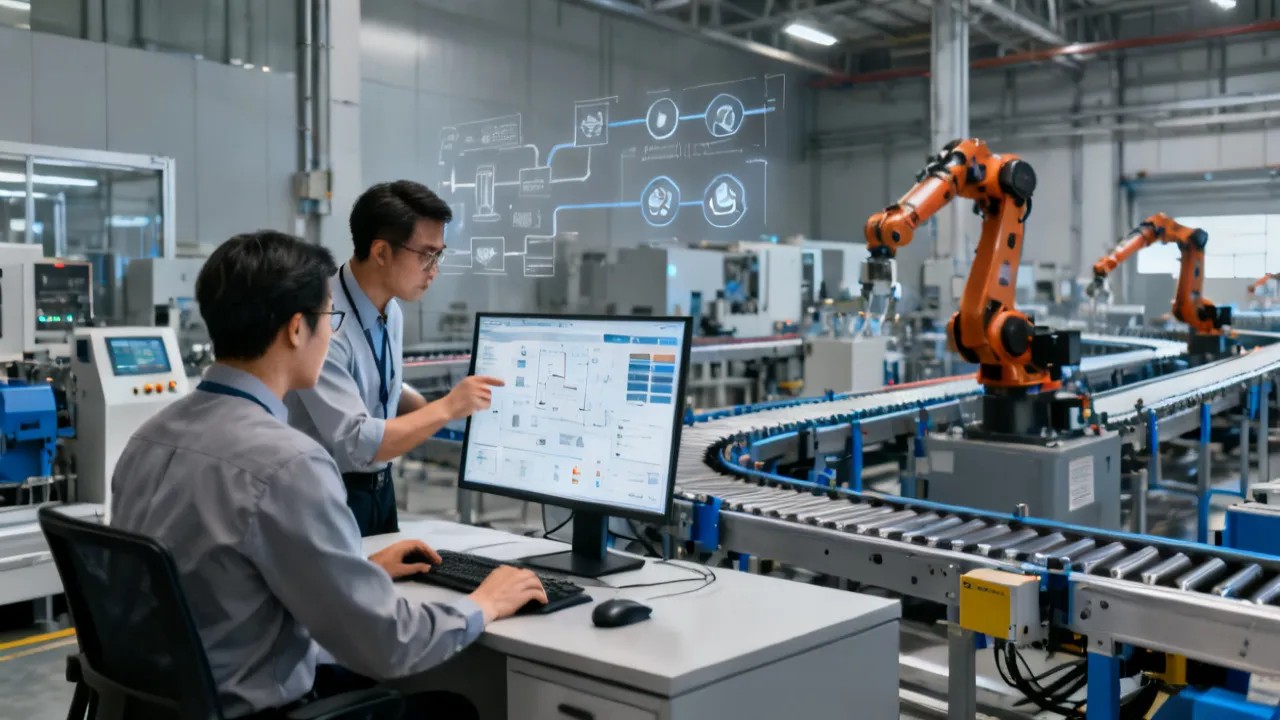
Ao desenhar um Scenario Automação, o ponto crítico é definir desde já o que será automatizado, quais dados entram e quais saídas (decisões e acionamentos) precisam ser confiáveis. Em contextos industriais, a automação não é apenas “instalar equipamentos”: é organizar fluxo de informação, padronizar interfaces e estabelecer governança para que a operação permaneça estável quando houver variação de demanda, manutenção e alterações de produto.
Do ponto de vista de um especialista, a melhor estratégia começa com três frentes simultâneas: processo (o que será controlado), arquitetura (como sistemas se conectam) e responsabilidade (quem valida, quem aprova mudanças e como se registra evidência). Isso reduz retrabalho e acelera a transição da fase de projeto para a operação assistida.
Para tornar essa decisão inicial mais “operacional” (ou seja, menos abstrata e mais verificável), normalmente se recomenda que o cliente e o time de engenharia respondam, logo nas primeiras iterações, a um conjunto de perguntas concretas. Por exemplo: qual operação será afetada diariamente pelo cenário? Quais modos de operação precisam existir (normal, degradado, manual, emergência)? Qual métrica vai guiar a aceitação (estabilidade, eficiência, qualidade, segurança)? Quais são as situações reais em que o sistema deve falhar de modo seguro? E, principalmente: quem tem autoridade técnica para aprovar que “o comportamento agora está correto”?
Outro aspecto que costuma passar despercebido no início é a definição do limite do sistema. Cenários industriais frequentemente evoluem em escopo. O limite pode ser entendido como “o que está incluído” e “o que não está incluído” na lógica do cenário. Se não houver esse contorno, é comum que integrações cresçam sem previsibilidade: um intertravamento que parecia responsabilidade do CLP acaba sendo cobrado no sistema de supervisão; um sinal que parecia “apenas para observação” termina exigindo resposta em tempo crítico; ou então uma condição de falha que era tratada localmente ganha impacto no nível de planta. Portanto, decidir cedo o limite do sistema é decidir também o que será responsabilidade de cada camada e de cada fornecedor (quando houver).
Por fim, ainda na decisão inicial, você deve estabelecer a tipologia das decisões que o cenário vai executar. Em automação, “decisão” pode significar desde uma regra simples (ex.: liberar válvula quando pressão excede um limiar) até uma sequência com múltiplos critérios (ex.: escolher modo de controle, classificar qualidade, decidir reset automático vs. reset manual) ou um procedimento de recuperação (recovery) após falha. A tipologia ajuda a dimensionar: o que é tempo-crítico precisa de engenharia e testes mais rigorosos; o que é informativo precisa de clareza de semântica e qualidade de sinal; e o que é regulatório (segurança funcional, requisitos de conformidade) exige disciplina de documentação e verificação.
O termo Scenario Automação costuma ser usado para descrever um conjunto coerente de premissas e escolhas: etapas do processo, lógica de controle, padrões de comunicação, necessidades de supervisão, níveis de segurança e rotinas de contingência. Um cenário bem definido evita lacunas comuns, como: automação sem estratégia de comissionamento, integrações sem mapeamento de dados e telas/relatórios que não refletem o comportamento real do chão de fábrica.
Em termos práticos, o cenário serve como “ponte” entre engenharia e operação: traduz requisitos em configurações e, depois, em operação cotidiana com métricas, logs e procedimentos de mudança.
Para entender “cenário” com mais precisão, vale separar a ideia em três componentes: premissas (o que é verdadeiro no ambiente, como variações esperadas e suposições), comportamento (o que o sistema faz em cada estado) e evidências (como provar que fez corretamente). Muitas vezes os projetos falham não por falta de tecnologia, mas por falta de evidência e de clareza sobre premissas. Exemplo típico: o cenário assume que o sensor sempre estará disponível; na prática, há janelas em que o sensor desliga para manutenção, ou há substituição em campo. Se essa premissa não for discutida, o cenário pode entrar em estados inesperados.
Outro detalhe: cenário não é apenas um “fluxograma” de processo. Ele deve incorporar também: latências de comunicação (o tempo entre leitura e comando), mecanismos de fallback (o que acontece se o dado estiver atrasado ou inválido), regras de indexação (como o sistema identifica “qual equipamento” está em cada situação), e as convenções de apresentação (como os dados são interpretados pelo usuário). Em automação madura, essas camadas se tornam consistentes: o operador entende o que está acontecendo, o técnico consegue diagnosticar e o engenheiro consegue reproduzir o comportamento em testes.
Também é útil pensar em “cenário” como um contrato: o contrato diz “se ocorrer A, então deve ocorrer B, sob condições C”. Esse contrato pode ser formal (com documentos e critérios de aceitação) ou informal (com acordos de equipe), mas em projetos industriais ele precisa ser suficientemente consistente para suportar comissionamento, operação e auditoria. Quando esse contrato não existe, o cenário vira “interpretação”: cada pessoa entende de um jeito, cada turno executa com base em memória, e qualquer mudança vira um risco não gerenciado.
Em resumo, “cenário” em automação é um conjunto que organiza: estados (quando o sistema está em qual modo), eventos (mudanças que disparam transições), ações (comandos e rotinas), observabilidade (logs, alarmes e métricas) e governança (como mudanças são feitas e validadas). Quanto mais completo esse conjunto, menos o projeto depende de “sensibilidade” individual e mais depende de engenharia e processo.
Especialistas em implementação de sistemas industriais sabem que o sucesso depende de como diferentes camadas trabalham juntas:
Quando essas camadas são tratadas separadamente, surgem inconsistências: o que aparece no painel não corresponde ao estado do processo; ou mudanças de configuração não são acompanhadas por revisão de risco; ou ainda a manutenção tenta “corrigir” sintomas, não a causa raiz.
Para aprofundar essa ideia, pense em um cenário típico de integração: o CLP determina que uma válvula deve abrir quando uma condição térmica é atingida. Porém, o sinal de temperatura chega ao CLP com latência e o valor pode “oscilar” por ruído. Se a lógica de controle foi desenhada com base numa leitura “ideal”, ela pode abrir e fechar em ciclos curtos. O painel pode mostrar o valor de temperatura suavizado, mas o CLP usa o valor bruto. O operador, então, percebe divergência e reduz confiança no sistema. Isso é integração falhando: não é somente tecnologia, é consistência entre camadas.
Outro caso comum ocorre quando a supervisão depende de tags “semânticas” que não foram padronizadas. Por exemplo, um mesmo conceito pode ser representado por tags diferentes em plantas diferentes (ou até em linhas diferentes dentro da mesma planta). Se o cenário não impõe uma convenção única (ou, ao menos, uma estratégia de equivalência), relatórios e indicadores se tornam incomparáveis. E indicadores que não são comparáveis dificultam decisões de melhoria contínua. A integração de dados, portanto, é um componente de governança.
Há também a integração de comportamento humano com o comportamento do sistema. A automação precisa ser operável. Isso significa que alarmes devem ser acionáveis (o operador consegue entender o que fazer), os modos devem ser claros (o operador sabe o que está em manual, o que está em automático e o que está em recuperação) e os procedimentos devem refletir a realidade. Se a lógica do cenário muda e a operação não é treinada (ou não é treinada de forma adequada), a integração “homem-sistema” quebra. E essa quebra é frequentemente a causa raiz de eventos, não a tecnologia.
Por fim, disciplina de integração envolve também gestão de ciclo de vida. Em automação, versões de software e firmware precisam ser controladas: o que foi testado na FAT é o que roda na SAT? O que foi comissionado é o que permanece depois de ajustes? Se a mudança é aplicada em campo sem rastreabilidade, o cenário deixa de ser um “contrato” e vira um conjunto de comportamentos acumulados. Dessa forma, a governança não é um “apêndice”: ela é uma parte central do cenário.
Mesmo sem entrar em valores específicos que variam por escopo, é importante entender que preço em automação costuma estar diretamente ligado a:
Em termos de tomada de decisão, o fornecedor deve ser avaliado não só por custo inicial, mas por capacidade de entregar documentação, evidências de testes, compatibilidade com infraestrutura existente e clareza de responsabilidades. Em projetos industriais, uma entrega “barata” pode custar caro se gerar retrabalho, indisponibilidade e custos de adaptação durante a operação.
É comum também que o fornecedor atue em “ilhas” de competência. Por exemplo: o fornecedor A entrega o CLP e a lógica de controle, o fornecedor B entrega supervisão e relatórios, e o fornecedor C entrega integrações de dados para sistemas corporativos. Se não existir um mecanismo de coordenação e um “dono do cenário”, o risco técnico aparece exatamente nas interconexões: semântica diverge, alarmes não estão alinhados com estados do processo, e transições de modo não seguem o que foi acordado. Portanto, é crucial entender não apenas o que cada fornecedor entrega, mas como eles co-administram o cenário como um sistema integrado.
Para avaliar fornecedores com mais maturidade, normalmente se recomenda observar “evidência de engenharia”, não somente promessas de prazo. Evidências incluem: relatórios de testes com critérios de aceitação, lista de desvios e resoluções, rastreabilidade de requisitos para casos de teste, diagramas de arquitetura (incluindo latências e mecanismos de fallback), e documentação de operação (como alarmes são interpretados e como executar recovery). Um fornecedor com governança tende a reduzir risco, mesmo que o custo inicial seja maior.
Outro fator que interfere em prazos e risco é a capacidade de comissionamento. Há empresas que tratam comissionamento como “ativar e verificar funcionamento básico”. Em cenários industriais, comissionamento é uma fase de estabilização, onde o sistema é submetido a variação real (ou o mais próximo disso) e a lógica precisa ser ajustada ou confirmada. Um fornecedor que não planeja comissionamento com observabilidade e plano de contingência pode estourar prazos e, pior, deixar “gargalos invisíveis” que aparecem mais tarde na operação.
Se você considerar operações em ambiente nearby (isto é, regiões próximas ao local do projeto), vale observar também fatores logísticos: disponibilidade de equipe para visitas, suporte em comissionamento e tempo de resposta para correções. Em geral, proximidade reduz atrasos e melhora a velocidade de aprendizagem durante a fase de ajuste fino.
Em termos de risco técnico, também importa a forma como o fornecedor lida com mudanças. Alguns fornecedores tratam alterações como “novas solicitações” sem reavaliar impacto no cenário como um todo; outros incorporam mudança com governança, avaliando o que muda em estados, em alarmes e em critérios de aceitação. Ao longo do tempo, esse comportamento separa um cenário confiável de um cenário “fragilizado por remendos”.
Um Scenario Automação eficiente costuma seguir uma lógica de “do abstrato para o concreto”:
Essa sequência reduz o “efeito túnel”, comum em projetos em que o foco excessivo em hardware deixa lacunas na validação de lógica e na gestão de mudanças.
Para tornar essa estrutura ainda mais robusta, vale detalhar como cada etapa “entrega algo” que alimenta a próxima. Por exemplo:
Esse enfoque de “entregáveis intermediários” evita um problema frequente: equipes que desenham o fluxo e pulam para lógica sem validar dados e qualidade; ou equipes que fazem testes de funcionamento, mas não verificam comportamento em estados degradados e de recuperação. Um cenário completo considera a realidade do mundo: sensores falham, válvulas travam, comunicação oscila, e o sistema precisa ter comportamento previsível nesses casos.
Além disso, a estrutura recomendada ajuda a organizar a colaboração entre diferentes perfis: engenheiros de controle, engenheiros de automação/comunicação, engenheiros de segurança, especialistas de dados e profissionais de operação e manutenção. Quando o cenário está segmentado por responsabilidades e entregáveis, a comunicação entre áreas melhora e reduz retrabalho.
Mesmo quando o escopo parece claro, projetos de automação falham por requisitos não documentados. Em “Scenario Automação”, alguns itens funcionam como pré-condições práticas:
Quando esses requisitos não são firmados, a equipe passa a “resolver no improviso” durante a partida, o que aumenta custo e risco de parada não planejada.
Para destravar projetos, especialmente na etapa de definição do cenário, há alguns requisitos que costumam ser determinantes. Um deles é a disponibilidade de dados de referência. Em automação, “dados” não são apenas sinais em tempo real: são valores de calibração, curvas de resposta, tabelas de limites e registros históricos que ajudam a calibrar alarmes e regras. Sem dados de referência, o cenário pode usar valores genéricos que não refletem o processo real, gerando excesso de alarmes (alarm flood) ou ausência de detecção de falhas importantes.
Outro requisito importante é a clareza sobre tolerâncias e limites. Muitas vezes existe uma diferença entre o que o processo “aceita” em termos de engenharia (por exemplo, limites de projeto) e o que o processo “tolera” em operação normal (por exemplo, limites de desempenho econômico). Se o cenário usa limites de projeto para gerar alarmes e interlocks, a planta pode ficar indisponível com frequência; se o cenário usa limites econômicos como se fossem limites de segurança, pode comprometer integridade. Portanto, a definição de critérios deve ser calibrada ao objetivo operacional do cenário.
Em seguida, existe a exigência de padronização de identificação. Isso parece simples, mas é onde muitas integrações falham. Exemplo: duas linhas podem usar tags parecidas, mas com diferenças no sufixo (L1 vs. L2), ou podem usar nomenclatura sem consistência para “falha”, “alarme”, “interlock”, “permissivo”. Se o cenário não impõe convenções, telas e diagnósticos ficam inconsistentes. A manutenção perde tempo interpretando; a operação perde tempo confirmando; e a equipe de engenharia perde tempo corrigindo.
Na gestão de mudanças, o requisito que destrava é a existência de um processo de aprovação. Sem esse processo, mudanças menores viram uma cadeia: alguém altera uma variável, outra pessoa ajusta um alarme, um operador muda uma configuração em runtime, e ninguém sabe o que foi feito. O cenário então perde rastreabilidade e vira uma caixa preta. Assim, a governança é essencial para manter confiabilidade durante o ciclo de vida.
Por último, treinamento é frequentemente subestimado. Treinamento não é apenas “ensinar a clicar em telas”. É ensinar o operador a interpretar estados e alarmes, a reconhecer sinais de deterioração antes de uma falha (preventivo), a executar recuperação corretamente e a entender limites de autonomia. Um bom cenário reduz risco porque torna o comportamento previsível para quem está na operação.
| Aspecto | Abordagem A: Customização por escopo | Abordagem B: Arquitetura padronizada com parametrização | Abordagem C: Modelo híbrido (padrão + pontos críticos customizados) |
|---|---|---|---|
| Controle e lógica | Maior ajuste ao processo específico; tende a demandar mais engenharia. | Base comum com parâmetros; reduz variação e padroniza manutenção. | Padroniza 70–90% e customiza “gargalos” e interfaces críticas. |
| Integração de dados | Mapeamento específico por planta/linha; maior risco de inconsistências se a convenção não for seguida. | Semântica uniforme; facilita escalabilidade e auditoria. | Mapeamento consistente com exceções controladas. |
| Tempo de entrega | Pode variar muito conforme complexidade; alterações são mais custosas se ocorrerem tarde. | Mais previsível por repetição de padrões. | Equilibra previsibilidade e flexibilidade. |
| Governança e auditoria | Depende do rigor documental do fornecedor e das revisões do cliente. | Facilita padrão de documentação e rastreabilidade. | Governança forte no padrão; customizações com trilha documental dedicada. |
| Custo total (ciclo de vida) | Pode crescer se a operação exigir ajustes recorrentes. | Geralmente mais estável por reduzir retrabalho. | Frequentemente otimiza custo ao longo do tempo. |
Para completar a leitura dessa tabela, é útil observar que as abordagens não são mutuamente exclusivas. Em muitos cenários, a “arquitetura padronizada” (abordagem B) é excelente para consolidar o que é repetível. Já os “pontos críticos” (abordagem C) costumam aparecer onde há risco operacional maior: interfaces singulares, requisitos especiais de segurança, ou lógicas de recuperação que diferem por planta devido a restrições físicas e diferentes rotinas de manutenção.
Um bom uso da abordagem C pode ser descrito como “padronizar a plataforma e deixar a planta respirar nos pontos necessários”. Na prática, isso significa que a base do cenário (estados, padrão de alarmes, semântica de tags, arquitetura de comunicação e formato de relatórios) é comum e testada de forma consistente. Só o que realmente precisa de variação recebe customização controlada. Essa estratégia reduz o risco de crescimento de esforço quando surgem mudanças tardias, porque a customização fica concentrada em áreas delimitadas e rastreáveis.
Por outro lado, na abordagem A, o risco principal aparece quando a customização vira “a única solução”. Se cada linha recebe um conjunto único de lógicas e semânticas, a operação pode ter mais dificuldade de padronizar treinamento e manutenção. O custo de ciclo de vida tende a crescer: cada modificação exige retrabalho de documentação e testes específicos. Em cenários com expansão futura, essa abordagem pode comprometer escalabilidade.
Assim, a tabela não deve ser vista apenas como uma escolha de estilo de fornecedor. Ela deve orientar o desenho do Scenario Automação como um “sistema evolutivo”. A evolução costuma ser inevitável: novos produtos, mudanças em rotinas, adaptações para manutenção e melhorias de desempenho. A abordagem escolhida determina como essas evoluções entram no cenário com menor risco.
A seguir, um roteiro prático em fases. Use como checklist para estruturar decisões e alinhar expectativa entre operação, engenharia e gestão:
Defina o problema operacional (qual gargalo, qual falha recorrente, qual meta de qualidade). Documente o que “sucesso” significa em termos mensuráveis e observáveis (por exemplo, estabilidade de ciclo, redução de paradas por evento específico, melhoria de rastreio de status).
Para tornar a triagem mais eficaz, inclua também uma lista de “eventos de referência”. Eventos de referência são ocorrências reais que já aconteceram (ou quase aconteceram) na planta: falhas de sensor, condições de intertravamento que pararam produção, alarmes que geraram confusão, casos em que a recuperação foi mal executada. Essa lista serve como base para desenhar casos de teste e para calibrar alarmes e critérios de validade. Sem eventos de referência, o cenário corre o risco de ser perfeito no papel e insuficiente na realidade.
Liste CLPs, IHM, sensores, atuadores, malhas, integrações existentes e necessidades de sinalização. Verifique limitações físicas (cablagem, espaço, alimentação, condições elétricas).
Além do inventário físico, inclua também o inventário de dados. Quais variáveis existem? Quais estão disponíveis com qualidade suficiente? Existem sinais redundantes? Existe histórico? Existe sincronismo temporal? O inventário de dados é onde você encontra “gaps” que, se ignorados, atrasam comissionamento. Por exemplo, um sensor pode estar disponível eletricamente, mas seu sinal pode não estar no formato necessário para o cenário (unidade diferente, escala não linear, ou ausência de calibração).
Defina modos: manual, automático, startup, parada segura, reset e condições de bloqueio. Isso evita “surpresas” quando o sistema muda de estado na prática.
Uma boa prática é desenhar uma matriz de estados x eventos. Isso ajuda a garantir que transições são consistentes e que cada estado tem responsabilidades claras. Também ajuda a definir quais ações são permitidas em cada estado. Por exemplo, em parada segura talvez seja proibida qualquer ação que possa energizar atuadores. Em modo manual, alarmes podem continuar monitorando condições, mas comandos automáticos não devem interferir. Esse tipo de disciplina evita comportamentos conflitantes.
Estabeleça padrões para nome de variáveis, unidades, limites e validação. Qualidade de dados importa: valores fora do esperado, ruído e atrasos precisam de regra explícita.
Critérios de qualidade devem incluir, além de limites, políticas de tratamento: filtragem temporal, deadband, supressão de ruído, regras para “valor travado” (quando o sensor não muda), e tratamento de desconexão. Em automação industrial, tratar “dado inválido” como “dado com valor fixo” pode ser perigoso. O cenário deve saber diferenciar “não medi” de “medi errado”. Isso vale tanto para controle quanto para alarmes e relatórios.
Determine como fluxos de comando e supervisão se segregam. Se houver exigência de segurança funcional, trate isso como disciplina de engenharia (avaliação de risco, requisitos e testes).
Mesmo quando não há segurança funcional formal (por exemplo, normas de safety), ainda existe segurança operacional: evitar que o operador crie condições perigosas, impedir comandos em estados incorretos e garantir que recovery não “volte” o processo a um ponto inseguro. A segregação de fluxos de comando e supervisão pode ser feita tanto por arquitetura (separar redes, rotas lógicas, níveis de permissão) quanto por software (mecanismos de habilitação e validação de permissivos).
Defina FAT/SAT (quando aplicável), testes de cenários de falha, validação de alarmes e verificação de rastreabilidade. Estabeleça “o que passa” e “o que não passa”.
Uma abordagem madura inclui testes de “qualidade de comportamento”, não só testes de “qualidade de sinal”. Por exemplo: não basta confirmar que o alarme dispara quando temperatura excede o limite; é preciso confirmar que ele dispara uma vez (sem repetição indevida), que sua causa raiz é registrada corretamente, que a intervenção do operador muda o estado para um modo esperado e que, após recuperação, o alarme reconfigura corretamente. Isso exige casos de teste que simulam a sequência completa e que verificam consistência entre estados e alarmes.
Durante a partida, priorize observabilidade: logs, alarmes e métricas de desempenho. Reforce o ciclo de aprendizado entre operadores e equipe técnica.
Curva de estabilização é o mecanismo pelo qual o cenário “aprende” com a realidade. Na prática, você estabelece um período em que erros de entendimento são esperados e tratados com prioridade (por exemplo, ajuste de lógica, ajuste de thresholds, correção de mapeamento de tags). Mas esse aprendizado deve ser controlado: cada ajuste precisa ter impacto avaliado, registro de versão, e verificação do que não se quebrou. Caso contrário, a estabilização vira desorganização.
Trate alterações de lógica e parâmetros como evento controlado: versionamento, aprovação, registro e verificação pós-mudança.
Uma “documentação viva” não é apenas manter arquivos atualizados. É manter correspondência entre documentos e o software em execução. Isso costuma exigir um método: antes de cada atualização, registra-se qual versão está sendo aplicada, o que foi alterado, quais requisitos/casos de teste foram afetados e como será validado. Quando esse método existe, a operação ganha previsibilidade: ela sabe como o cenário se comportou antes e depois de cada mudança.
Garanta que operação e manutenção saibam interpretar alarmes, executar recuperação e entender quando chamar suporte do fornecedor.
Treinamento deve ser orientado a cenários, não apenas a conceitos. Por exemplo: “se o sistema entrar em modo recovery, execute X; se ocorrer alarme Y, verifique Z; se o equipamento permanecer em estado W, chame suporte após uma checagem de 5 itens”. Rotinas de manutenção devem incluir verificação de integridade de tags, checagem de qualidade de sinal e inspeção de interfaces que impactam o cenário. Assim, manutenção deixa de ser apenas substituição e passa a ser diagnóstico.
Execute uma auditoria técnica leve após o período inicial para identificar ajustes de arquitetura, lacunas documentais e melhorias para a próxima etapa do cenário.
Essa revisão deve focar em: o que gerou alarmes não esperados, quais transições de estado ocorreram fora do previsto, quais dados estavam fora de limite de qualidade e quais procedimentos foram executados de maneira diferente do esperado. A ideia é transformar incidentes em melhorias no cenário, e melhorias precisam ser reincorporadas com governança.
Para reduzir risco, é recomendável que o caderno de requisitos inclua:
Essa base é especialmente relevante quando existe exigência de implantação em região nearby, pois logística, presença de equipe e velocidade de correção dependem do planejamento.
Para tornar os requirements ainda mais “blindados”, inclua também definições explícitas sobre:
Esses pontos evitam discussões “depois que já está rodando”. Em automação, muitas dificuldades aparecem quando as pessoas tentam definir responsabilidades após o comissionamento começar. Ao incluir esses requisitos antes de assinar, você cria um arcabouço para resolver incidentes com método.
Outro ponto de atenção é o acesso a dados. A contratação deve prever acesso a sinais e histórico para validação e testes. Se o fornecedor não tiver acesso adequado, ele pode não conseguir calibrar alarmes ou verificar qualidade de dados durante a SAT. Isso aumenta o risco de transferência de conhecimento no final do projeto, ou seja, de aprender “com o cliente na operação”.
Por fim, considere cláusulas que definam como incidentes serão tratados durante a estabilização: prazos de correção, critérios de severidade e procedimento de comunicação. Sem isso, o cenário pode ficar instável por longos períodos, e o custo de oportunidade da indisponibilidade cresce.
Para apoiar a gestão de risco e governança em projetos de automação, vale considerar normas e diretrizes amplamente aceitas no setor, como padrões de segurança e práticas de engenharia de sistemas. Entre referências úteis, encontram-se:
Para estatísticas de adoção e tendência de automação, procure relatórios de entidades reconhecidas do setor (por exemplo, associações industriais, agências governamentais e consultorias com metodologia publicada). Como os números variam por região e ano, o essencial aqui é: use dados oficiais e metodologia explícita ao comparar cenários de investimento e risco.
Além de normas, muitas equipes se beneficiam ao usar frameworks de engenharia de requisitos e validação. A lógica é que o cenário precisa ser verificável. Isso pode ser sustentado por abordagem de “traceabilidade”: requisitos conectados a casos de teste, e casos de teste conectados a evidências (logs, relatórios, capturas de tela, arquivos de configuração e versões). Quando esse encadeamento existe, a auditoria técnica fica mais simples e a equipe aprende mais rápido com incidentes.
Uma fonte confiável também é o histórico do cliente: dados de falhas passadas, incidentes de comissionamento anteriores, e lições aprendidas de projetos similares. Historicamente, muitos erros repetidos não são culpa de falta de tecnologia, mas de falta de padronização de lições aprendidas. Portanto, ao embasar decisões, considere criar uma base interna de conhecimento. Essa base pode incluir: padrões de alarmes que deram certo, políticas de filtragem que reduziram alarmes falsos, convenções de tags que facilitaram manutenção, e checklist de comissionamento que evitou retrabalho.
Se o projeto envolve segurança funcional, as normas IEC citadas fornecem estrutura para analisar risco e definir requisitos. Nesse contexto, “cenário” precisa contemplar não só funcionamento desejado, mas também como o sistema deve se comportar em modos perigosos. Assim, evidências de teste devem incluir verificação dos interlocks e do comportamento em falhas. Evidenciar isso é mais importante do que presumir.
Por fim, uma boa prática de governança é definir o que conta como evidência suficiente. Evidência pode ser: logs com timestamp, registros de versões, relatórios de teste, prints de telas com estados e alarmes, e arquivos de configuração. Se a organização não define o que aceita como evidência, cada projeto vira uma negociação no final. Isso aumenta risco e consome tempo de gestão.
É um conjunto de premissas e decisões que organiza o projeto de automação: processos, lógica de controle, arquitetura de comunicação, requisitos de segurança, critérios de aceitação e rotinas de operação. Em outras palavras, define como o sistema deve se comportar em diferentes estados e como será validado antes de operar continuamente.
Na prática, o cenário materializa-se em artefatos: diagramas de estados, lista de tags com semântica, definição de alarmes e severidades, regras de transição de modo, plano de testes e procedimentos de recuperação. Ele também se materializa em configurações e versões do sistema. Assim, quando alguém pergunta “qual é o cenário?”, a resposta deve apontar para algo que possa ser revisado e auditado, não somente uma descrição verbal.
Como regra profissional, padronize o que é repetível (arquitetura, convenções de dados, rotinas de supervisão) e customiza pontos que realmente dependem do processo (lógica específica, interfaces singulares e regras do fluxo). O risco maior da customização é o crescimento do esforço de engenharia quando surgem mudanças tardias.
Uma técnica útil é usar uma escala de criticidade: classifique componentes do cenário (por exemplo, módulos de estados, alarmes, integração de dados, recovery). Componentes de baixa criticidade podem ser totalmente padronizados; componentes de alta criticidade podem ter customização controlada. Isso evita “customizar tudo” e ajuda a manter governança e previsibilidade.
Não. Em projetos de automação, o custo total geralmente reflete engenharia, integração, comissionamento, testes, documentação, treinamento e suporte. Uma solução com hardware semelhante pode ter preços bem diferentes por causa do nível de integração, evidência de testes e governança do ciclo de vida.
Em outras palavras: “hardware” é apenas parte do cenário. O que determina custo é a capacidade de transformar requisitos em comportamento verificável e sustentado. Se a solução reduz o número de alarmes falsos, melhora diagnóstico e diminui retrabalho de manutenção, ela pode ter custo inicial maior, mas custo total menor.
O fornecedor influencia a qualidade do projeto por meio de metodologia de entrega, capacidade de integração, clareza de documentação, gestão de mudança e suporte no período de estabilização. Avalie entregáveis e evidências, não apenas custo inicial.
Também é importante avaliar como o fornecedor se comporta quando surgem problemas. Cenários confiáveis são construídos com resposta madura a incidentes: o fornecedor investiga causa raiz, registra aprendizados, e ajusta o cenário com trilha documental e testes de verificação.
Priorize: mapeamento de dados (tags e unidades), modelagem de estados (modos e interlocks), alarmes acionáveis, plano de testes com critérios objetivos e preparação de operação/manutenção. Falhas comuns surgem quando a lógica é “conceitualmente correta”, mas não corresponde ao comportamento real sob variação de carga e falhas de campo.
Além disso, revise a observabilidade: logs suficientes para rastrear sequência de eventos, alarmes com mensagens que indiquem ação recomendada, e métricas que permitam medir desempenho. Sem observabilidade, o comissionamento vira “apagando incêndio” e não estabilização.
Estabeleça governança: solicitação formal de mudança, avaliação de impacto (processo e segurança), versionamento, testes pós-mudança e registro. Sem controle, a automação vira um conjunto de ajustes acumulados e a confiabilidade cai.
O ideal é que mudanças sejam tratadas como projetos menores com critérios de aceitação. Mesmo pequenas alterações podem impactar estados e transições. Portanto, o método de mudança deve considerar consistência do cenário como um todo.
Sim. Se houver possibilidade de adicionar linhas, máquinas ou novas integrações, a arquitetura e as convenções de dados precisam ser planejadas para escalabilidade. Isso evita “ilhas” de sistemas e reduz custo futuro de integração.
Planejar expansão envolve: arquitetura modular, nomenclatura consistente, e padrões de integração que permitam replicar módulos com parametrização. Também envolve tratar limites de desempenho (capacidade de comunicação e histórico) para que o cenário não degringole quando crescer.
Além de custo logístico, considere disponibilidade de equipe, previsibilidade de visitas, tempo de resposta e facilidade de validação presencial. Planejamento de comissionamento e janelas de testes costuma funcionar melhor quando a estratégia de atendimento é compatível com o cronograma operacional.
Em cenários nearby, muitas vezes o risco diminui porque a equipe consegue fazer ajustes e validar rapidamente. Porém, essa proximidade não elimina necessidade de governança. Ajustes rápidos sem registro podem gerar instabilidade futura. Assim, “nearby” melhora velocidade, mas governança continua indispensável.
Um Scenario Automação bem estruturado transforma objetivos operacionais em comportamento verificável: define estados, integra dados com significado, estabelece critérios de aceitação e cria rotinas de mudança e suporte. Na prática, isso reduz riscos de indisponibilidade, melhora a capacidade de diagnóstico e facilita evolução contínua do sistema.
Se você está avaliando contratação, vale lembrar: preço e prazo importam, mas a robustez do cenário—especialmente em integração e documentação—tende a ser o fator que determina a qualidade do resultado. Ao preparar requisitos, planejar a execução passo a passo e alinhar expectativas com o fornecedor, a automação deixa de ser um projeto pontual e vira uma competência sustentável.
Em ambientes industriais, o improviso custa caro porque transforma a confiabilidade em uma propriedade “emocional”: depende de quem está de plantão, de como cada operador interpreta alarmes e de quão bem cada pessoa conhece o que foi alterado no passado. Governança, ao contrário, torna o cenário previsível: as regras são registradas, as transições têm critérios, os testes geram evidência e as mudanças são controladas. Assim, a automação se torna um sistema que não apenas responde ao presente, mas consegue evoluir com segurança.
Portanto, a mensagem final é direta: trate o Scenario Automação como um “sistema de engenharia” e não como uma coleção de componentes. Ao construir o cenário com disciplina de integração e governança, você reduz risco, acelera comissionamento e cria uma base sólida para melhorias futuras. Quando a operação confia no comportamento do sistema e a manutenção consegue diagnosticar com base em estados e evidências, a automação cumpre seu papel: tornar o processo mais estável, mais eficiente e mais seguro—não só no dia do start-up, mas por todo o ciclo de vida.



This guide explains how Vitrali Moema helps residents near São Paulo evaluate stained-glass (vitrail) options by focusing on design, materials, installation readiness, and good durability. It provides objective background on what “vitrali” typically implies in the Brazilian market, the role of glass types and lead/cementitious frameworks, and how suppliers assess measurements, lighting conditions, and building constraints.
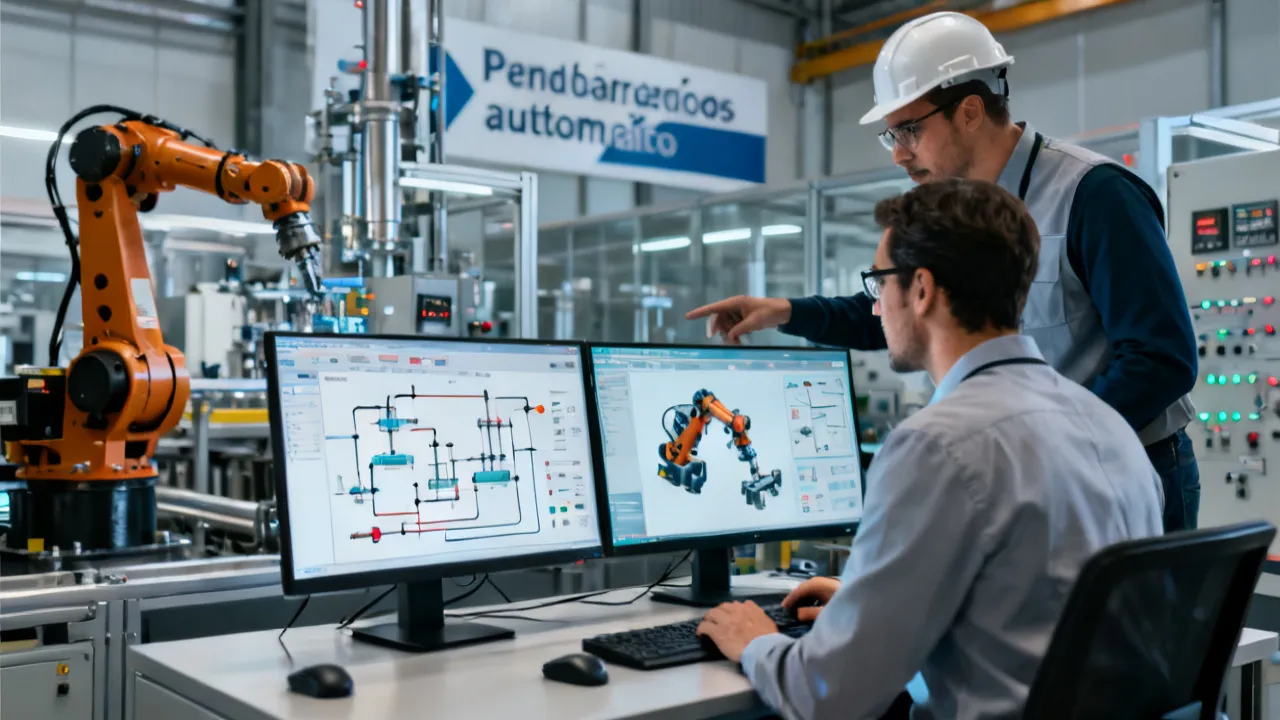
Este guia analisa como estruturar um Scenario Automação para integrar instrumentos, software e processos com rastreabilidade e segurança. Em seguida, apresenta de forma objetiva o contexto de automação industrial, a lógica de cenários (pré-condições, gatilhos e exceções) e como preparar requisitos operacionais, validação e governança para reduzir retrabalho e falhas.
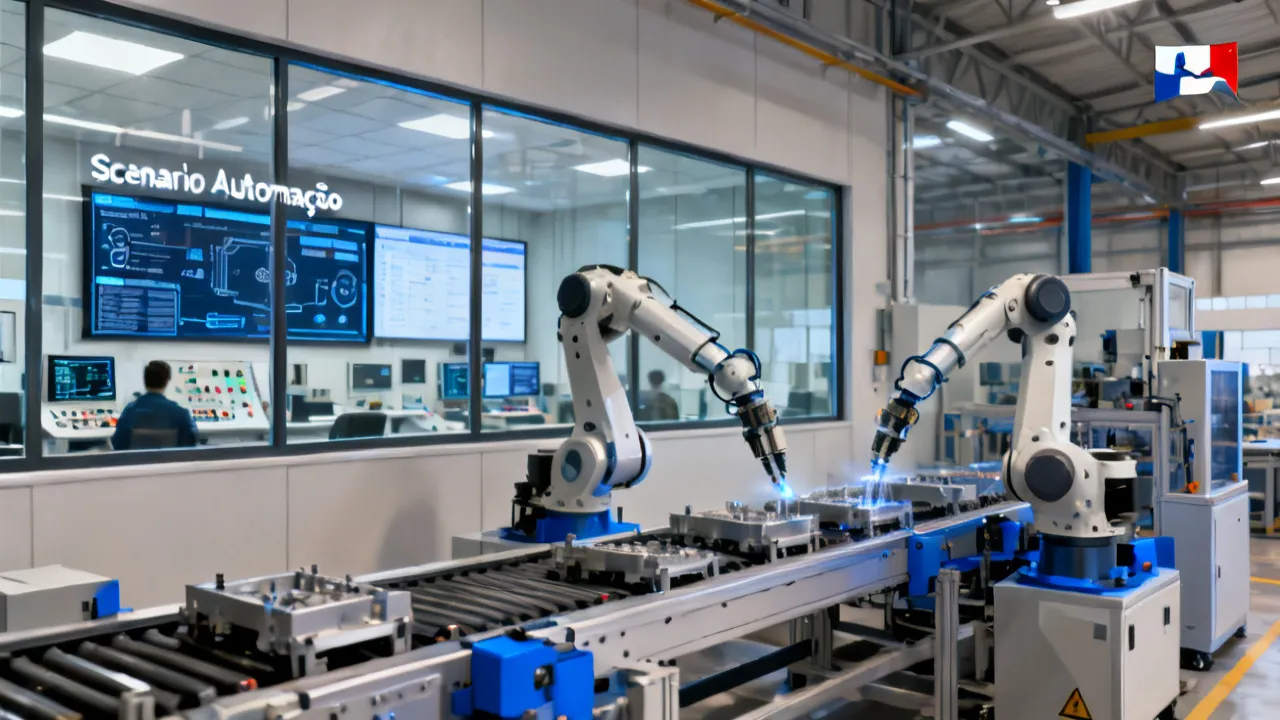
Este guia apresenta como desenhar e implementar Scenario Automação para padronizar processos, reduzir variação operacional e aumentar a previsibilidade. Em seguida, contextualiza objetivamente o que significa automatizar cenários de decisão, quais etapas costumam ser usadas por integradores e quais requisitos técnicos precisam ser considerados para manter rastreabilidade, segurança e continuidade operacional.
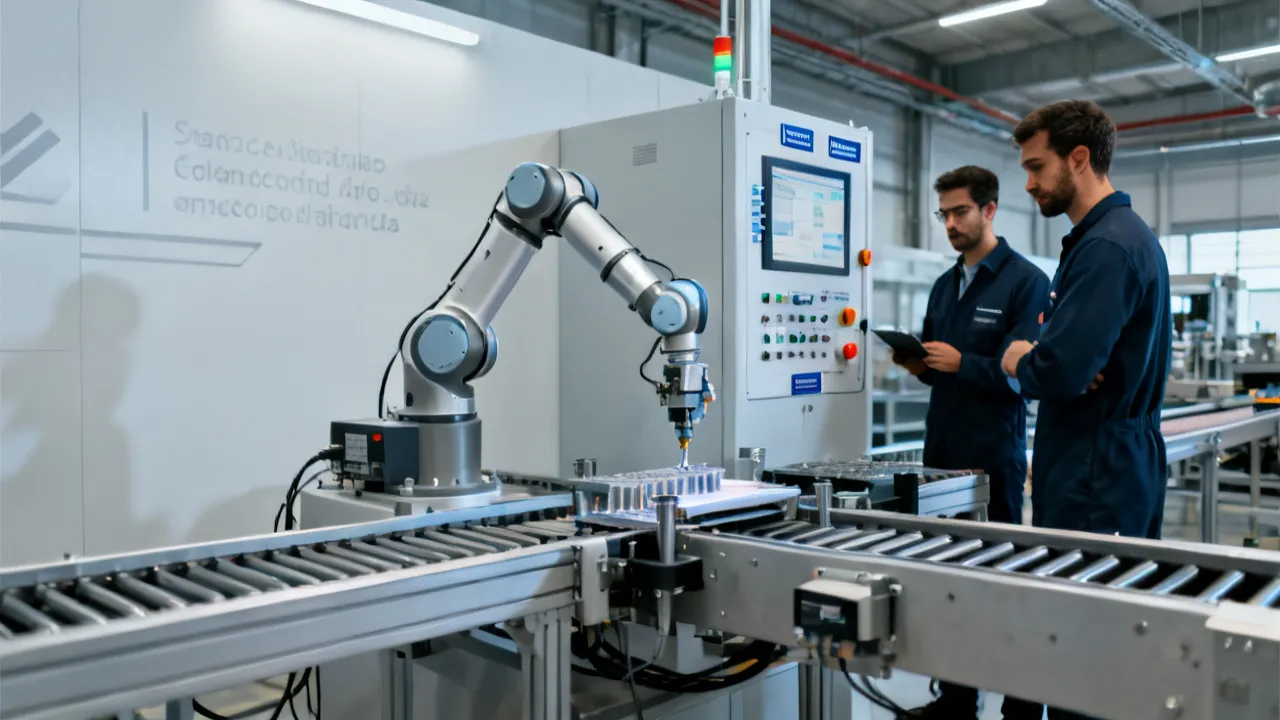
Este guia técnico analisa o “cenário automação” e como estruturar projetos de automatização com governança, integração e segurança. Você verá, de forma objetiva, o que considerar ao definir etapas, requisitos e critérios de desempenho, além de orientações práticas para alinhar pessoas, processos e tecnologia em diferentes ambientes industriais e de serviços.
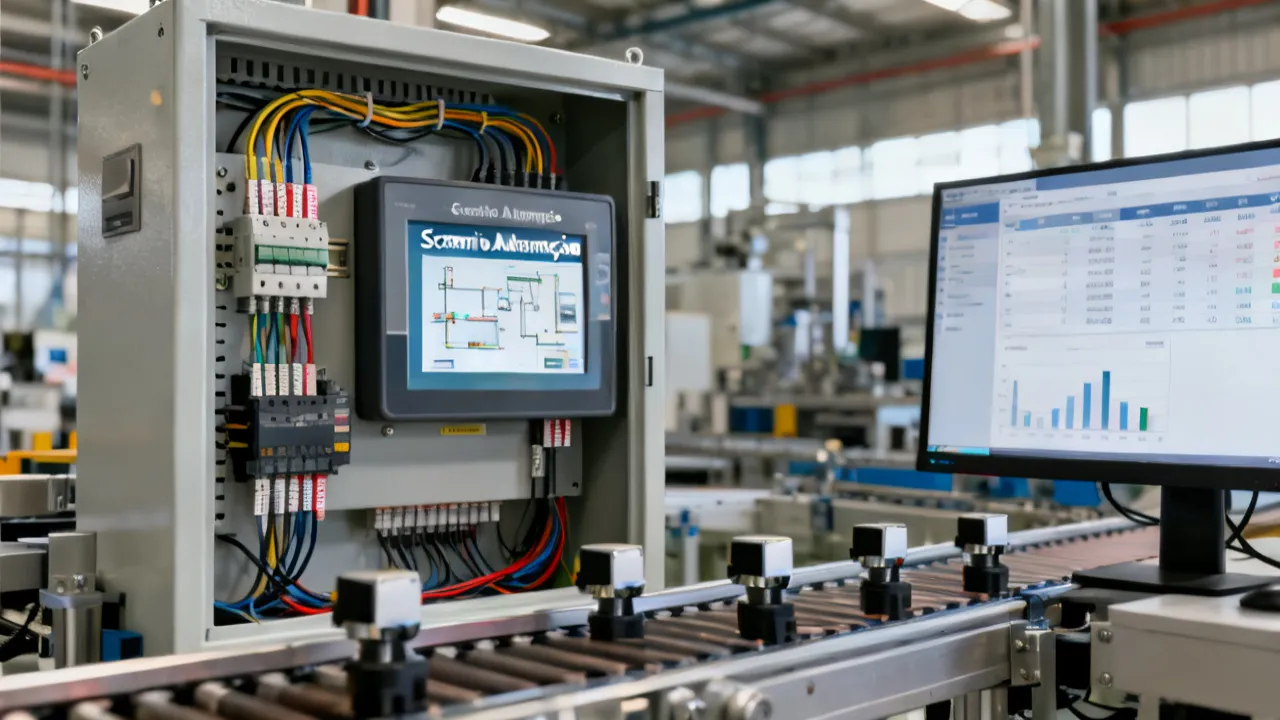
Este guia técnico explica como estruturar um Scenario Automação para reduzir ineficiências, padronizar processos e aumentar a previsibilidade operacional. O texto contextualiza o conceito de automação por cenários, discute integração com sistemas e níveis de controle, e orienta a definição de condições e requisitos para implementação segura e escalável, com visão objetiva do mercado e boas práticas.
Este guia explica como estruturar um Scenario Automação para integrar processos, dados e controles com segurança operacional. Em seguida, apresenta de forma objetiva o que envolve automação industrial, por que a escolha do fornecedor impacta o retorno, e como alinhar requisitos técnicos, governança e etapas de implantação para reduzir riscos e aumentar previsibilidade.

